
智能工厂不是买来的一套软件,是按五层长出来的
多数失败的项目,是把五层当成一次性采购。真正能落地的做法,是让每一层单独产生价值、单独收回下一层的预算。
我们做软件与集成
网关、传感器、PLC、交换机由你或集成商供货。我们出选型清单与验收标准,并负责把它们的信号变成可用的数据——不赚硬件差价,也不做「装完就走」的布线队。
一期只承诺三个数字
报工及时率、稼动率可见度、追溯查询耗时。这三个指标在签约前测一次基线,验收时再测一次。说不出基线、也不肯测的项目,我们不做。
四个角色必须到场
生产经理定口径、设备主管定点位、质量定判定标准、IT 定网络与账号。缺一方,项目就停在那个人身上——这是最常见的延期原因,而不是技术难题。
五类模块:先上哪一类,比用什么技术更重要
五个模块可以独立交付,也可以叠加。下表是常见的范围、周期与首期预算区间,用来判断一期该切多大。
| 模块 | 解决什么问题 | 核心功能 | 典型周期 | 首期预算 |
|---|---|---|---|---|
| MES 生产执行 | 订单做到哪一步、瓶颈卡在哪个工序、在制品有多少 | 工单派工、工序流转、扫码报工、在制品看板、质量判定与返修 | 8–14 周 | 30–80 万 |
| 设备联网采集 | 稼动率靠人估、故障靠人喊、停机原因没人记 | 网关采集、状态判定、报警推送、OEE 自动计算、设备台账 | 4–8 周 | 10–30 万 |
| 车间大屏 | 数据在班组长脑子里,管理层看不到真实进度 | 产量与节拍、异常与停机、订单进度、多屏轮播与权限视图 | 3–6 周 | 5–15 万 |
| 物联网平台 | 设备分散在多厂多客户,每接一种设备就要改一次代码 | 物模型、设备接入与鉴权、规则引擎、OTA、多租户与开放 API | 8–16 周 | 20–60 万 |
| 自动化控制 | 关键工艺参数漂移,靠老师傅手动回调 | 闭环调节、阈值与联锁、参数下发与审计、异常回归记录 | 按项目 | 15–60 万 |
我们不接的三类项目:只要硬件不要软件(只装传感器、不做数据闭环);「先做出来再谈需求」(范围不可控,一定返工);承诺「OEE 提升 20%」却不肯先测基线(没有基线,就没有验收标准,最后只能扯皮)。
一条数据从设备到看板,中间有六个环节
看板不好用,问题几乎不在看板本身,而在它左边那五个环节。每个环节都有典型的时延,也都有典型的坑。
数据质量的四条硬规矩
这四条不写进设计文档,系统上线三个月后一定会返工。它们跟用什么技术无关,只跟约定有关。
- 点位命名先定规则:线体-工位-设备-量-单位,例
L2-ST03-WELD01-CURR-A。名字错了,后面所有报表都要跟着改。 - 状态判定要有依据:运行 / 待机 / 故障 / 停机 由 PLC 信号判定,不靠电流阈值猜——猜出来的稼动率没人信。
- 时间戳以设备为准:网关定期与服务器校时,把时钟偏差记进日志。跨班次、跨时区的统计全依赖这一条。
- 断网必须有兜底:边缘节点本地缓存 ≥7 天原始数据,恢复后按时间戳补传、云端幂等去重。车间断一次网,那批数据不能永久缺口。
设备怎么接:九种采集方式与它们的真实成本
「支持 OPC UA」这句话,十家设备厂有十种含义。下表按实际对接经验整理,用来估算现场工作量。
| 方式 / 协议 | 能采到什么 | 典型设备 | 难点 | 增量成本 |
|---|---|---|---|---|
| Modbus RTU(RS485) | 寄存器数值、线圈状态 | 变频器、温控表、电表、老 PLC | 要厂商提供地址表;同名寄存器在不同厂商含义不同 | 低 |
| Modbus TCP | 寄存器数值、线圈状态 | 带网口的仪表、小型 PLC | 站号与端口配置;多主站访问冲突 | 低 |
| OPC UA | 结构化变量,带类型与语义 | 西门子、倍福、罗克韦尔新机型 | 需厂商开放 UA 服务器与权限;老机型要另加 OPC 服务 | 中 |
| Siemens S7 | DB 块、M 区、I/Q 点 | S7-200 / 300 / 400 / 1200 / 1500 | DB 偏移要按结构体算;不同版本符号表对不上 | 中 |
| 三菱 MC / 欧姆龙 FINS | 数据寄存器、链接区 | 日系 PLC、日系机床 | 老设备串口速率低,采集周期受限于 200ms 以上 | 中 |
| MQTT | 设备或网关主动上报的数据包 | 新型仪表、DTU、AGV、能耗表 | 主题设计、QoS 等级、离线消息堆积 | 低 |
| 厂商私有串口协议 | 按厂商文档解析的报文 | 称重仪、检测仪、老专机 | 常缺文档,需抓包反推;工期不可控 | 高 |
| IO / 干接点 | 只有开与关、有与无 | 老设备、三色灯、安全门、气缸 | 拿不到工艺数值,只能判状态 | 低(信息量也低) |
| 人工 / 扫码录入 | 工位平板扫码、手工填数 | 手工作业工位、外协工序 | 及时性与准确性靠管理,不靠技术 | 低 |
采集前先填一张表:设备清单 × 通讯方式 × 可采点位 × 采集周期 × 责任方(谁提供文档、谁开权限)。这张表在免费的需求调研阶段给出,也是判断一期能做多大范围的唯一依据。预约设备联网可行性评估 →
OEE:先把口径定下来,再谈提升
同一台设备、同一个月,换个口径就能算出 15 个点的差距。所以第一件事不是买系统,而是把三项指标的定义写成一张表,双方签字。
| 指标 | 定义 | 数据从哪里来 | 最容易做错的地方 |
|---|---|---|---|
| 可用率 A | 运行时间 ÷ 计划生产时间。计划生产时间 = 日历时间 − 计划停机(保养、无订单、节假日) | PLC 运行信号 + 排产计划 | 把计划停机算成损失,OEE 永远上不去,改善方向也错了 |
| 性能 P | 理论节拍下的产出时间 ÷ 运行时间(含空转、小停顿、降速) | 产量计数 + 工艺标准节拍 | 理论节拍用「历史最快」还是「设备铭牌」,必须写死一个,中途不许换 |
| 良率 Q | 合格品数 ÷ 总产出。总产出含试机品、返修品 | 质检判定 + 返修记录 | 试机品悄悄不计入,良率虚高,成本却真实发生 |
五个常见的口径坑
- 换型时间算不算停机?算,但必须单列成「换型损失」。混进故障停机里,你会去买更贵的设备,而真正该做的是 SMED(快速换模)。
- 多品种共线怎么算?按品种产量加权,不能简单平均——否则小批量高节拍的品种会把整体性能拉高。
- 停机原因谁填?只让操作工选原因,不让填文字。文字原因在三个月后会有一百种写法,一条都统计不了。
- 一天按 24 小时还是按班次切?MES 按班次、大屏按自然日,是「两块屏对不上」的头号原因。
- 设备离线时算停机吗?不算,但要单独统计「采集不可用时长」。否则网关掉线会被记成设备故障,维修班白跑。
物联网平台的核心不是接了多少设备,而是中间那张物模型表
物模型是设备与应用之间唯一的合同。定义一次,设备侧和应用侧就可以各自演进:换设备不改应用,改应用不动设备。
| 物模型字段 | 示例 | 为什么必须有它 |
|---|---|---|
| 设备 ID | GW01-PRESS-07 | 唯一且不变。设备改名、移位、换厂区,历史数据仍挂在同一个 ID 上 |
| 点位键 | spindle_temp | 语义稳定,与寄存器地址解耦。PLC 换型号只改映射,不改报表 |
| 数据类型 | float / int / bool | 决定存储类型与展示方式;类型错一位,曲线就是锯齿 |
| 单位与量纲 | °C、mm/s、kWh | 换算放前端还是后端,要在设计时定,不能两边各算一次 |
| 精度与死区 | 0.1 / 死区 0.5 | 直接决定上报频次与存储成本。不加死区,一条温度曲线能把一年的存储吃掉 |
| 采集周期 | 1 s / 60 s / 事件触发 | 按时序库容量反算成本;不是所有点位都需要秒级 |
| 归属维度 | 线体 / 工位 / 客户 / 合同 | 决定谁能看、费用怎么分摊。多租户平台没有这一列,做不了对外收费 |
规则与告警
阈值、连续 N 次越限、去抖、班次内累计、联动工单。告警必须能落到人:谁接、多久响应、超时升级给谁——否则只是屏幕上的一片红。
时序数据服务
原始数据按周期降采样为分钟/小时/日三级,长期留存原始值 1–2 年、聚合值不限期。查询走聚合表,翻一年前的曲线不用等。
设备管理与 OTA
台账、生命周期、远程配置、固件升级与回滚。升级必须支持灰度:先 1 台、再 1 条线、再全厂,失败自动回滚——这一步偷懒会把整厂网关刷成砖。
边缘还是云端:九成工厂应该选混合
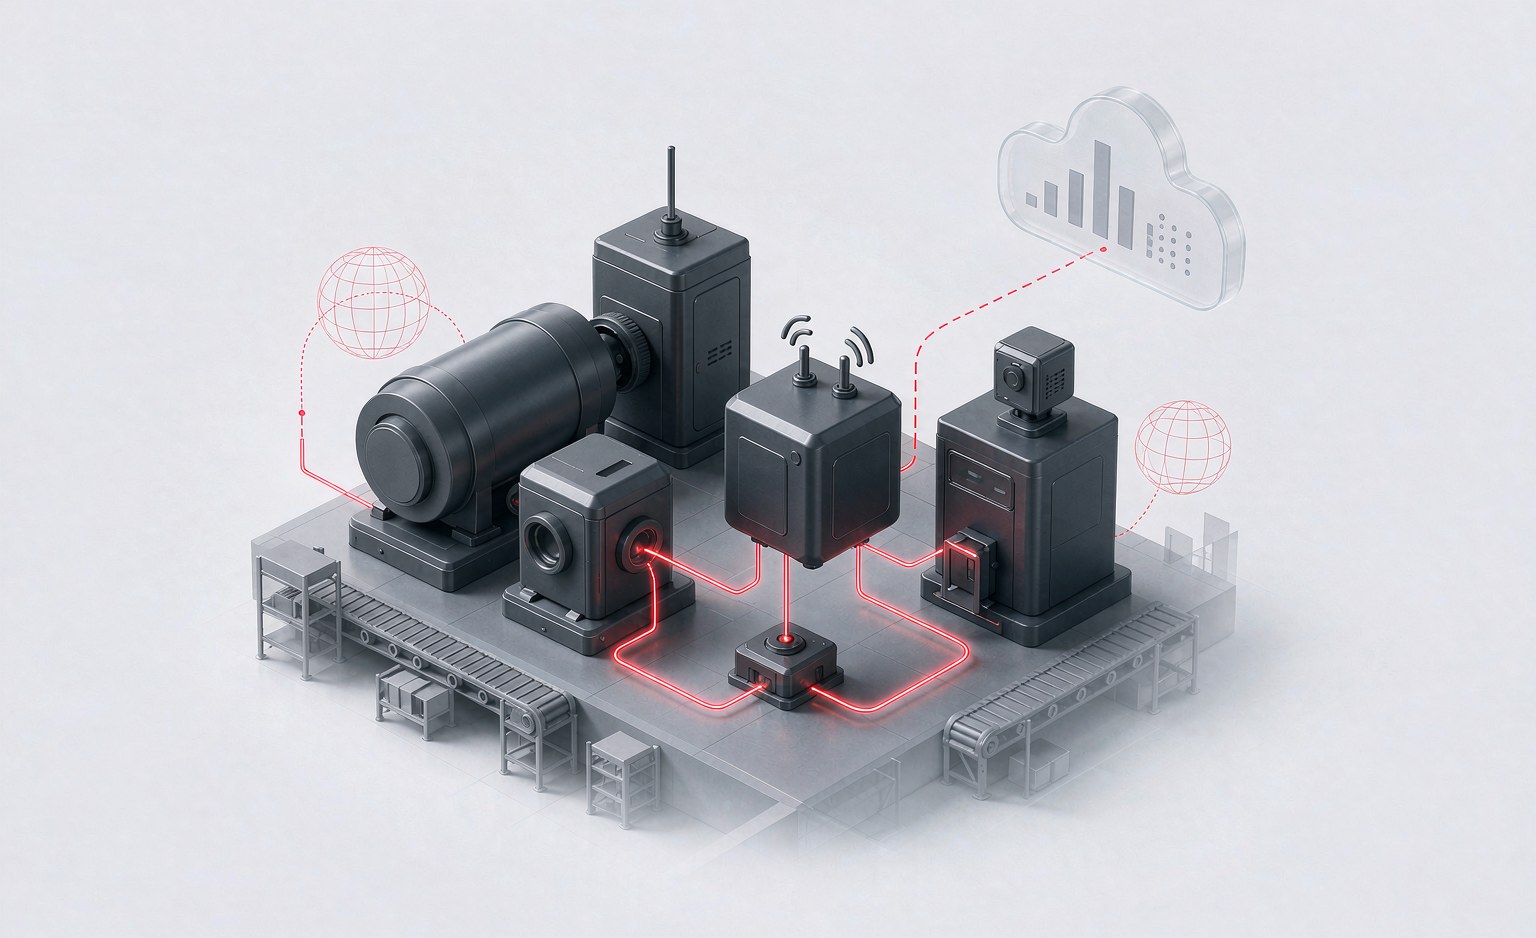
边缘负责「不能等」的事,云端负责「要算很久」的事。把两者混为一谈,要么贵得离谱,要么断网就瘫。
一条判断标准就够了
如果这个动作必须在 100 毫秒内完成,或者断网也必须继续跑,它就在边缘;其余全部上云。按这条标准切,边界从来不模糊。
- 边缘:采集与协议转换、状态判定、断网缓存与补传、实时联锁与声光报警、本地 HMI 展示。
- 云端 / 机房:历史存储与聚合、跨线体与跨厂对比、报表与成本核算、模型训练、多租户与开放 API。
- 红线:安全联锁绝不放在云端。网络抖一下就让设备停机的设计,不是智能工厂,是事故源。
| 对比维度 | 纯边缘 | 纯云端 | 混合(推荐) |
|---|---|---|---|
| 采集时延 | 毫秒级 | 受公网抖动影响,100ms–2s | 毫秒级判定 + 秒级上云 |
| 断网可用性 | 完整可用 | 数据中断,控制失效 | 现场不停,数据补传 |
| 历史与跨厂分析 | 容量有限,难做 | 强 | 强 |
| 单点成本 | 每线一台盒子,硬件成本前置 | 低,按量付费 | 中等,但可分期 |
| 适用场景 | 单机设备、离线场景 | 能耗监测、远程运维 | 绝大多数制造现场 |
车间大屏的三条规矩,和四种典型错误
大屏不是「把报表搬上墙」。它只服务一个场景:班组长站在三米外,十秒内知道要不要叫人。
规矩一:一屏只回答一个问题
本班产量达成、设备异常、订单进度——一屏选一个。想在一屏里同时呈现三件事,结果是三件都看不清。
规矩二:三米外能看清
主数字 ≥ 120px,一屏数字不超过 7 个。其余全部降级为辅助信息或干脆移出屏幕。
规矩三:异常优先
正常状态不着色,异常才用红色 + 闪烁 + 声音,并且能在 30 秒内定位到具体工位与设备。全屏都是红黄绿,等于没有信号。
必须写上的三行小字
数据截至时间、统计口径(含不含试机品)、责任人。没有这三行,现场就会开始怀疑数字,然后不再看它。
四种典型错误
- 把 20 张图表塞进一屏——信息量越大,决策速度越慢。先删到 7 个数字,再谈美化。
- 红黄绿三色表示三种不同的东西——红色既是「停机」又是「超产」又是「待检」,现场会直接无视所有颜色。
- 数据延迟 5 分钟——超过 3 秒的看板,班组长就不会看第二眼;超过 1 分钟,就只剩领导检查时才亮。
- 只做一块屏、不做轮播与权限——车间要产量、设备科要故障、厂长要订单,三块视图轮播,比做一块「什么都有」的屏有用得多。
分五步走,每一步都能单独验收
跳过第二步直接上全厂 MES 的项目,八个月后大概率只剩一块没人看的大屏。下面是我们实际使用的推进节奏。
三条红线,用来判断一个方案能不能落地:一期不超过 12 周;一期必须能独立上线并产生价值;一期必须有一个人对结果负责(不是委员会)。三条里缺一条,就把范围再切小一次。
六类行业的物联网应用场景
同一个平台,换个行业就是另一套点位与规则。下表是我们做过或评估过的场景,写明采什么、值在哪。
| 行业 | 采集对象 | 典型应用 | 价值落点 |
|---|---|---|---|
| 制造业 | PLC、机器人、专机、能耗表 | 工单执行、稼动率、质量判定、预测性维护 | 停机时间下降、直通率提升、换型时间缩短 |
| 物流仓储 | 车载终端、门禁、温湿度、地磅 | 车队实时调度、路线优化、在途温控、月台排队 | 空驶率下降、准时率提升、货损减少 |
| 农业与食品 | 气象站、土壤、温室执行器、分选线 | 气候监测、温室自动化、批次溯源、分选品质 | 损耗下降、可追溯、溢价能力 |
| 能源与环保 | 电表、水表、气体传感器、排口监测 | 分项计量、峰谷优化、超标预警、碳排核算 | 能耗成本下降、合规风险可控 |
| 医疗与实验室 | 冷链探头、试剂库存、设备运行状态 | 温控断链预警、试剂效期管理、设备利用率 | 合规审计通过、耗材浪费减少 |
| 商业与门店 | 客流计数、POS、冷柜、照明与空调 | 客流分析、陈列优化、设备远程管控 | 坪效提升、运维人力减少 |
FAQ
常见问题
上线后员工不愿意用怎么办?
这是最常被低估的风险。我们的做法:工位界面由实际使用者参与设计、上线首两周驻场或远程值守、按角色分别培训并留录屏、把"必须进系统"的动作和考核挂钩(这条需要你们内部推动)。系统难用和员工抵触,往往是同一件事的两面。
后期维护怎么收费?
质保期内(通常 12 个月)缺陷修复免费。质保期后的运维可选年度服务包或按次计费,两种方式的计费项在合同中列明,不收取模糊的"年度服务费"。
我们有自己的 IT 团队,能和你们配合吗?
可以,而且通常更顺。典型分工是:你们负责服务器、账号、网络与内部流程决策,我们负责应用代码、接口与发布。交付时提供接口文档与部署手册,后续你们可以自主接手维护,我们转为按次支持。

